
Day 17 透過 Prompt Engineering,已經可以讓 Gemini 以 SOC Analyst Assistant 的角色分析 Security Event。不過 AI 的回答雖然人看得懂,但程式不一定容易處理。
例如 LLM 可以用自然語言說明事件摘要、風險程度與建議,但每次回答的句型與排列方式都可能不同。如果未來希望將這些內容顯示在 SOC Dashboard 的不同區塊,就需要讓輸出具有固定的資料結構。
因此今天嘗試使用 Structured Output,將 AI 的分析結果轉換成 JSON 格式。
建立structured_output.py
from google import genai
client = genai.Client()
event = """
Event Type: Network Scan
Source IP: 192.168.3.100
Destination IP: 192.168.3.141
Destination Port: 80
Protocol: TCP
Signature: Possible Network Scan
Severity: 2

"""
prompt = f"""
You are a SOC Analyst Assistant.
Severity definition:
1 = High
2 = Medium
3 = Low

Analyze the following security event:
{event}
Return the result in JSON format with exactly these fields:
summary
severity
attack_type
risk
recommendation

Do not include explanations outside the JSON.
"""

response = client.models.generate_content(
    model="gemini-flash-lite-latest",
    contents=prompt
)
print(response.text)

這種方法雖然通常可以得到 JSON 格式的內容,但本質上仍然只是要求模型按照文字指令產生特定格式,未必適合程式長期穩定處理。
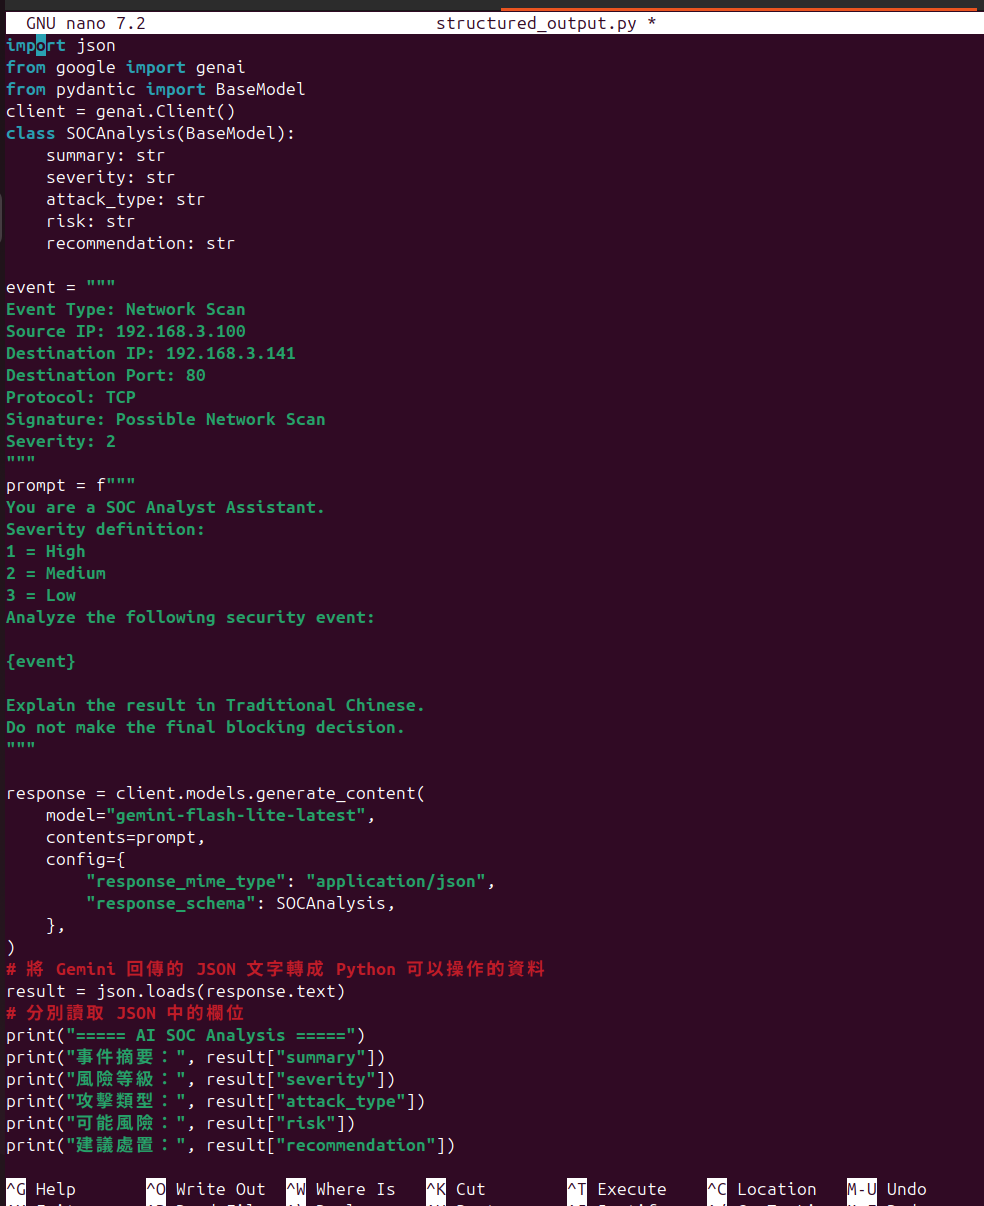
Google Gen AI SDK 支援以 response schema 約束結構化輸出。我用 Python BaseModel 來定義 SOC 分析結果的資料結構。
將內容改成:
from google import genai
from pydantic import BaseModel
client = genai.Client()
class SOCAnalysis(BaseModel):
    summary: str
    severity: str
    attack_type: str
    risk: str
    recommendation: str
event = """
Event Type: Network Scan
Source IP: 192.168.3.100
Destination IP: 192.168.3.141
Destination Port: 80
Protocol: TCP
Signature: Possible Network Scan
Severity: 2
"""
prompt = f"""
You are a SOC Analyst Assistant.
Severity definition:
1 = High
2 = Medium
3 = Low
Analyze the following security event:
{event}

Do not make the final blocking decision.
"""

response = client.models.generate_content(
    model="gemini-flash-lite-latest",
    contents=prompt,
    config={
        "response_mime_type": "application/json",
        "response_schema": SOCAnalysis,
    },
)
print(response.text)
Google 的 Gemini API 文件目前提供 Structured Outputs,能以 JSON Schema 指定模型回傳格式;Python SDK 也支援使用 Pydantic model 作為 schema。
Python 解析 Gemini Structured Output 執行結果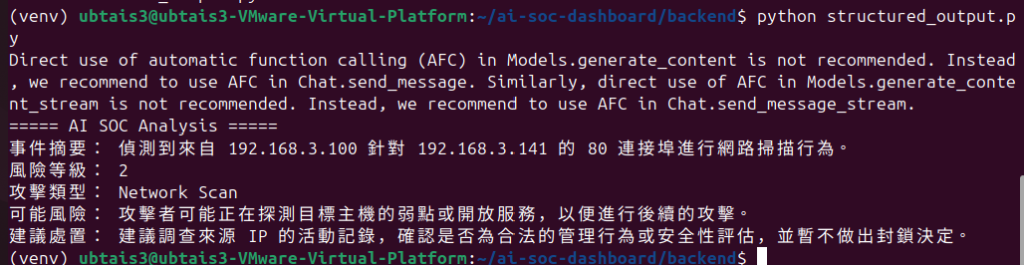
Gemini 回傳 JSON 後,後端利用 Python 的 json.loads() 將 JSON 字串轉換為可操作的資料結構,再分別取得 summary、severity、attack_type、risk 與 recommendation 等欄位。這代表 AI 的輸出已不再只是供人閱讀的自然語言,而是能夠被後端程式進一步處理的結構化資料。


從 Day 1 一路追到現在,看著這個平台從事件搜尋、統計,一步步長到串接 LLM、調 Prompt,今天再把輸出變成結構化資料,每一篇都剛好接在前一篇的痛點上,節奏很舒服。特別喜歡這篇先示範「只靠 Prompt 要求 JSON」再換成 response schema 的對照寫法,讓人一眼看懂為什麼需要 Structured Output。已經過半了,剩下 12 天加油!
幾個小建議,供後續參考:
severity 可以用 Enum 限制:現在是 str,模型可能回 "2"、"Medium" 或 "medium"。改成 Literal["High", "Medium", "Low"] 或 Enum,Dashboard 做顏色、篩選時會穩定很多。
嚴重度對應交給程式做:1/2/3 對應 High/Medium/Low 是確定性的規則,後端直接轉換就好,不必讓 LLM 再判斷一次,把它留給 summary、risk 這類真的需要推理的欄位。
直接用 response.parsed:SDK 傳入 Pydantic model 時,可以直接拿到 SOCAnalysis 物件,不用自己 json.loads(),還多一層型別驗證。也建議補上驗證失敗或輸出被截斷時的處理(重試或標記為「分析失敗」)。
幫欄位加說明:用 Field(description="...") 描述每個欄位要填什麼,例如 risk 和 summary 的差別,輸出品質會更一致。
固定模型版本:gemini-flash-lite-latest 是會變動的別名,哪天模型換版,同一筆事件的結果可能不同。平台要穩定的話,建議指定明確版本。
Prompt Injection 值得寫一天:事件裡的 Signature、Payload、User-Agent 都是攻擊者可以控制的內容,直接塞進 prompt 有被注入的風險。既然是 AI Security 組,這個主題很適合放在後面。
期待看到 AI 分析結果接回 Dashboard 的那天!


 iThome鐵人賽
 看影片追技術